"אנחנו רוצים להקים מודל בינה מלאכותית משלנו. כזה שיישב אצלנו, ישמור על המידע ויענה לצרכים שלנו בלבד." כך פתח סמנכ"ל הטכנולוגיה של ארגון פיננסי גדול את הפגישה הראשונה שלנו. הרעיון נשמע מצוין: לא להיות תלויים בגורמי חוץ, לשמור מידע רגיש בבית, ולבנות יכולת פנימית שתשרת את כולם, משירות הלקוחות ועד ההדרכה.
המקרה אמיתי. הפרטים המזהים שונו.
בקצרה- ארגון פיננסי השקיע חצי שנה במודל AI פנימי, ושילם פי שלושה בשביל עשירית מהתוצאה.
- ברוב הארגונים, מודל מסחרי בגרסה ארגונית, עם השחרת מידע, הרשאות ונהלים, זול, מהיר ומדויק יותר.
- מודל מקומי מוצדק בכמה מצבים מוגדרים: רשת מנותקת, איסור רגולטורי מפורש, עבודה בלי אינטרנט, או משימה צרה בנפח עצום.
- לפני כל החלטה, מחשבים כמה יעלה מודל מסחרי בפועל. ברוב הארגונים מדובר בעשרות שקלים לעובד בחודש.
חצי שנה של התלהבות, ואז המספרים
הם בנו צוות, שכרו יועצים, רכשו שרתים והתחילו לאמן מודל על הנתונים של הארגון. בהתחלה הייתה אווירה של סטארט-אפ: המהנדסים התרגשו, ההנהלה עודדה, כולם הרגישו פורצי דרך.
ואז הגיעו המספרים. שרתים עולים הרבה. מומחי AI פנימיים עולים עוד יותר. והמודל? עדיין לא נתן תוצאות טובות יותר ממערכות שקיימות בשוק. "אנחנו משלמים פי שלושה, ומקבלים עשירית ממה שציפינו," סיכם המנמ"ר אחרי חצי שנה. "והכי מתסכל? אם היינו משקיעים את אותם משאבים בהטמעה חכמה של מודל קיים, כולל אבטחת מידע, הדרכות ותהליכים, כבר היינו עם מערכת עובדת."
ואז, מחוץ לחדר, הוא הוסיף משפט שאני זוכר עד היום: "גיליתי שהעובדים המאוכזבים לא מתלוננים. הם פשוט עובדים עם המודלים בחוץ, ואין לנו שליטה על זה."
מה באמת קרה כאן
הטעות לא הייתה טכנית. היא הייתה טעות בהערכה של שלושה דברים: רגישות המידע (רובו לא דרש מודל פנימי), היכולת להחזיק מודל (שזה פרויקט שלא נגמר), והעלויות (שתמיד גבוהות מהתכנון). בינתיים, המודלים המסחריים השתפרו בקצב שאף צוות פנימי לא יכול להדביק. כל חודש שהארגון השקיע בפיתוח, הפער רק גדל.
ויש כאן טעות רביעית, שקטה יותר: הם ניסו לאמן מודל. היום כמעט אף ארגון לא צריך לאמן מודל שפה מאפס. מי שבאמת חייב לעבוד מקומית לוקח מודל פתוח מוכן, מריץ אותו על השרתים שלו ומחבר אותו לידע הארגוני דרך חיפוש במסמכים (RAG). כוונון עדין (Fine-tuning) נשמר למשימות צרות מאוד, ורק אחרי שהגרסה הפשוטה הוכיחה את עצמה.
"מרבית הארגונים לא באמת צריכים מודל פנימי. הם צריכים דרך בטוחה להשתמש במודל קיים. זה פחות מרגש בישיבת הנהלה, אבל זה עובד." ליאור אברהם, מייסד ארגון ה-AI הישראלי
שלוש אפשרויות, לא שתיים
הוויכוח בארגונים נשמע בדרך כלל כמו "מודל משלנו מול ChatGPT". בפועל יש שלוש דרכים, וההבדל ביניהן הוא בעיקר איפה המידע מעובד ומי מחזיק את התשתית:
| אפשרות | מה זה | מתאים ל |
|---|
| מודל מסחרי בגרסה ארגונית | Claude, GPT או Gemini בחשבון ארגוני, עם הסכם עיבוד נתונים, בלי אימון על המידע שלכם | רוב העבודה היומיומית: כתיבה, סיכומים, חיפוש בידע, קוד, בוט שירות |
| מודל מסחרי בתוך הענן של הארגון | אותם מודלים דרך Amazon Bedrock, Azure או Google Cloud, בתוך החשבון והרשת של הארגון | ארגונים שכבר בענן ורוצים בקרה, הרשאות ויומני שימוש בכלים שהם מכירים |
| מודל פתוח שרץ אצלכם | מודל עם משקולות פתוחות (למשל gpt-oss, Gemma, Qwen או Mistral) על שרת בארגון או בענן פרטי | רשתות מנותקות, איסור רגולטורי מפורש, משימות צרות בנפח עצום |
נקודה שכדאי לבדוק עם הספק ולא להניח: "בענן בישראל" לא תמיד אומר "מעובד בישראל". AWS השיקה את Bedrock באזור תל אביב בספטמבר 2025, אבל לפי התיעוד של Anthropic מודלי Claude זמינים שם דרך נקודת קצה גלובלית, שמנתבת את הבקשות בין אזורים בעולם. גם ב-Azure, זמינות המודלים משתנה לפי אזור וסוג הפריסה. אם יש לכם דרישה שהמידע יעובד בישראל, בקשו אותה בכתב, לכל מודל בנפרד.
מתי ארגון באמת צריך מודל מקומי
אחרי לא מעט שיחות עם מנמ"רים ומנהלי אבטחת מידע, אלה המצבים שבהם אני ממליץ לבחון ברצינות מודל שרץ אצלכם:
- רשת מנותקת. גופי ביטחון, תשתיות קריטיות או מערכות מסווגות שאין להן חיבור לאינטרנט בכלל. כאן אין שאלה: אם רוצים AI, הוא חייב לרוץ בפנים.
- איסור מפורש ולא תחושה. רגולטור, חוזה עם לקוח או חובת סודיות שאוסרים להעביר סוג מסוים של מידע לצד שלישי, גם לא בהשחרה. בבנקים, למשל, הוראת ניהול בנקאי תקין 362 של בנק ישראל מגדירה כללים לשימוש בענן ומטפלת בנפרד בפעילות ובמערכות ליבה. אבל שימו לב: ברוב המקרים הבדיקה המשפטית מגלה שמותר לעבוד עם ספק חיצוני בתנאים מסוימים, ולא שאסור.
- עבודה בלי אינטרנט. רצפת ייצור, אתר בנייה, ספינה, מכשיר בשטח. מודל קטן שרץ על המכשיר עצמו עובד גם כשאין קליטה.
- משימה צרה בנפח עצום. סיווג של מיליוני מסמכים, חילוץ שדות מטפסים קבועים, תיוג פניות. משימה כזו לא צריכה את המודל החכם בעולם, ובנפחים גבוהים מאוד מודל פתוח קטן על שרת שעובד מסביב לשעון יכול לצאת זול יותר.
- יש מי שיחזיק את זה. שני אנשים לפחות שמבינים בהרצת מודלים, עדכוני גרסה, ניטור ואבטחה, ותקציב לשנה השנייה והשלישית. בלי זה, כל אחת מהסיבות למעלה לא מספיקה.
ומתי לא (כלומר, ברוב המקרים)
- "אנחנו לא סומכים על הענן" בלי לבדוק מה כתוב בהסכם. בגרסאות הארגוניות של הספקים הגדולים המידע לא משמש לאימון כברירת מחדל, ויש הסכם עיבוד נתונים, הרשאות ויומני שימוש. את זה כדאי לקרוא לפני שמקימים חוות שרתים.
- עוזר כללי לעובדים. כתיבה, סיכום, ניתוח וקוד הם בדיוק המקומות שבהם הפער בין המודלים המובילים לבין מה שאפשר להריץ בבית הכי מורגש.
- בוט שירות ללקוחות. טעות של בוט מול לקוח עולה ביוקר. כאן רוצים את המודל הכי מדויק, והעלות שלו קטנה ביחס לחיסכון. את החשבון אפשר לעשות במחשבון בוט השירות.
- ארגון של עשרות או מאות עובדים. בגודל הזה החשבון כמעט אף פעם לא מסתדר לטובת שרת משלכם, כפי שתראו מיד במחשבון.
- החשש הוא מידע אישי. את רוב המקרים האלה פותרים בהשחרה לפני השליחה, ולא בהקמת תשתית.
החלופה שעובדת: השחרה ומודל חיצוני
במקום להחזיק תשתית מודל שלמה, אפשר להשחיר את המידע הרגיש על שרת מקומי, להפוך אותו ללא מזוהה, ורק אז לשלוח אותו למודל חיצוני בגרסה ארגונית. כך שומרים על הפרטיות, חוסכים בעלויות, ומקבלים תוצאה איכותית יותר ומהר יותר.
יש גם דרך ביניים שהולכת ומתפשטת: ניתוב לפי רגישות. מודל פתוח קטן רץ אצלכם ומטפל רק במסמכים הרגישים באמת, וכל השאר הולך למודל מסחרי. כך משקיעים בתשתית מקומית רק בשביל החלק הקטן שבאמת צריך אותה.
ואל תשכחו את הצד המשפטי. תיקון 13 לחוק הגנת הפרטיות, שנכנס לתוקף באוגוסט 2025, נתן לרשות להגנת הפרטיות סמכות להטיל עיצומים כספיים, והרשות כבר השתמשה בה. המשמעות לארגון: צריך לדעת איזה מידע אישי נשלח לאיזה כלי, ולתעד את זה. וזה נכון בין אם המודל רץ אצלכם ובין אם בחוץ. מודל מקומי לא פוטר מנהלים, הרשאות ואבטחת מידע.
כמה זה עולה באמת: בדקו במחשבון
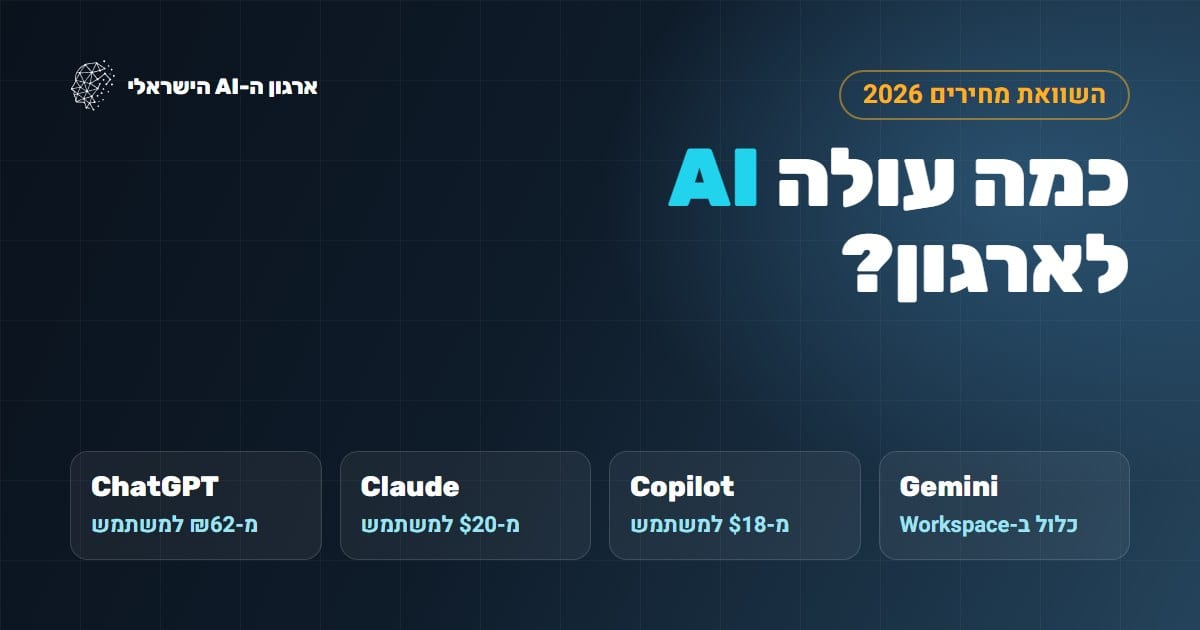
רוב הוויכוחים על מודל מקומי מתנהלים בלי מספרים. אז הנה המספרים. במחשבון שלמטה מזינים כמה עובדים יש בארגון, מה הם עושים עם AI ובאיזה מודל, ומקבלים עלות חודשית ושנתית לפי המחירון הרשמי של הספקים. ברוב הארגונים שבדקנו, עובד משרד ממוצע עולה כמה עשרות שקלים בחודש.
עכשיו השוו את התוצאה לצד השני של המשוואה. מודל פתוח חזק כמו gpt-oss-120b של OpenAI צריך, לפי כרטיס המודל, כרטיס גרפי אחד של 80GB כמו H100, וגרסת ה-20b שלו מסתפקת ב-16GB. כרטיס כזה עולה עשרות אלפי דולרים לרכישה, או בסביבות 2 עד 4 דולר לשעה בהשכרה בענן, כלומר אלפי שקלים בחודש אם הוא דולק מסביב לשעון. וזה עוד לפני השרת, הגיבוי, החשמל, ובעיקר האנשים: מהנדס אחד שמתחזק את כל זה עולה לארגון יותר מהחשבון החודשי של מאות עובדים במודל מסחרי.
אם התוצאה במחשבון שלכם יוצאת עשרות אלפי שקלים בחודש, בעיקר מעיבוד מסמכים אוטומטי וסוכנים, שווה לבדוק מודל מקומי למשימות האלה בדיוק. אם היא יוצאת כמה אלפי שקלים, התשובה כמעט תמיד ברורה. כדי לבדוק אילו מודלים פתוחים בכלל ירוצו על החומרה שיש לכם, השתמשו במחשבון תאימות המודלים המקומיים.
טבלת החלטה: לבנות או לא
| שאלה | אם התשובה "כן" | אם התשובה "לא" |
|---|
| האם רגולציה, ביטחון או חוזה אוסרים במפורש שהמידע יצא מהארגון, גם בהשחרה? | מודל מקומי שקול | מודל מסחרי עם השחרה |
| האם המערכת חייבת לעבוד בלי חיבור לאינטרנט? | מודל מקומי, כנראה קטן | אין סיבה לרוץ בפנים |
| האם מודלי המדף נכשלו במשימה הספציפית שלנו, אחרי בדיקה אמיתית? | יש הצדקה לבחון חלופה | אין סיבה לפתח |
| האם עלות הטוקנים החודשית במחשבון גבוהה מעלות של שרת ואיש צוות? | שווה לבדוק מודל מקומי למשימות הכבדות | מודל מסחרי זול יותר |
| האם יש צוות ותקציב לתחזוקה לשנים, לא רק להקמה? | אפשר להתקדם | הפרויקט ייתקע בשנה השנייה |
רק אם התשובה לאחת משלוש השאלות הראשונות היא "כן", וגם לשתיים האחרונות, מודל מקומי הוא כנראה ההחלטה הנכונה. וגם אז, בדרך כלל רק לחלק מהמשימות.
השוואת עלויות: על מה באמת משלמים
| רכיב | מודל מקומי | מודל מסחרי בגרסה ארגונית |
|---|
| הקמה | שרתים או GPU, התקנה, חיבור למערכות, בדיקות איכות | הגדרה, השחרה, חיבור למערכות |
| עלות שוטפת | תשתית, חשמל או השכרת GPU, אנשי צוות קבועים | רישיונות או תשלום לפי שימוש (טוקנים) |
| איכות לאורך זמן | תלויה בהחלפת מודל ידנית כשיוצא מודל פתוח טוב יותר | משתפרת עם כל דור מודלים חדש |
| זמן עד ערך | חודשים | שבועות |
| שליטה במידע | מלאה, אם האבטחה הפנימית טובה | תלויה בהסכם, בהשחרה ובאזור העיבוד |
| מתי זה משתלם | נפח עצום ויציב של משימה צרה, או חובה לעבוד מנותק | כמעט כל שימוש אחר |
איך תדעו שאתם בכיוון הלא נכון
- הפרויקט נמדד ב"כמה התקדמנו באימון", ולא ב"כמה עובדים משתמשים ומה זה חוסך".
- אין השוואה מסודרת בין המודל הפנימי לבין מודל מסחרי על אותן משימות.
- אף אחד לא חישב כמה היה עולה אותו שימוש במודל מסחרי.
- העובדים ממשיכים להשתמש בכלים חיצוניים כי "המערכת שלנו עוד לא מוכנה".
- התקציב לשנה השנייה לא הוגדר, כי "נראה איך זה ילך".
תבנית: בדיקה של שבועיים לפני שמחליטים
- בוחרים 3 משימות אמיתיות שהמודל הפנימי אמור לפתור.
- משחירים את המידע הרגיש, ומריצים את אותן משימות על שניים או שלושה מודלים מסחריים מובילים.
- מריצים את אותן משימות גם על מודל פתוח אחד או שניים, למשל Gemma או gpt-oss, בכלי כמו Ollama לבדיקה, או vLLM לשרת אמיתי.
- מודדים איכות, זמן ועלות לכל משימה, ומכניסים את נפחי השימוש הצפויים למחשבון הטוקנים.
- רק אם המודלים המסחריים נכשלו בבירור, או שהחשבון החודשי גבוה מעלות של תשתית וצוות, יש הצדקה לדון בפתרון מקומי.
מה זה אומר לארגון שלכם
השאלה הנכונה היא לא "איפה המודל יושב", אלא "איזה מידע יוצא, למי, ובאיזה תנאים". ברוב הארגונים התשובה היא מודל מסחרי בגרסה ארגונית, השחרה של מה שרגיש באמת, נוהל שימוש ברור ומעקב אחרי הצריכה. תבניות למדיניות ולנהלים תמצאו בערכת הטמעת ה-AI החינמית שלנו, ואת בקרת הצריכה החודשית בערכת בקרת הטוקנים ובמדריך מי מפקח על הטוקנים בארגון. עוד כלים ומקרים בתחום תמצאו בעמוד AI ל-IT ואבטחת מידע.
ארגון ה-AI הישראלי · לארגונים
השימוש ב-AI בארגון שלכם מאובטח?
Shadow AI, דליפת מידע והרשאות לסוכנים. נבנה איתכם שימוש בטוח ב-AI בלי לחסום את העבודה.
לבדיקת אבטחת ה-AI בארגון ←שיחת היכרות של 20 דקות, בלי עלות ובלי התחייבות. הפנייה מגיעה ישירות לליאור.
השורה התחתונה
בינה מלאכותית טובה היא לא רק שורת קוד. היא אסטרטגיה שמתחילה בהבנת הצרכים מול מה שכבר קיים בשוק. ברוב המקרים, פתרון חיצוני עם הטמעה חכמה, נהלים ברורים ואחריות על פרטיות ייקח את הארגון הרבה יותר רחוק, בהרבה פחות זמן. מודל מקומי הוא כלי טוב למצבים מוגדרים, לא נקודת פתיחה. ואם אתם מתלבטים בין המודלים המסחריים עצמם, השוואה מעודכנת תמצאו במדריך Claude 5.5 לארגונים.