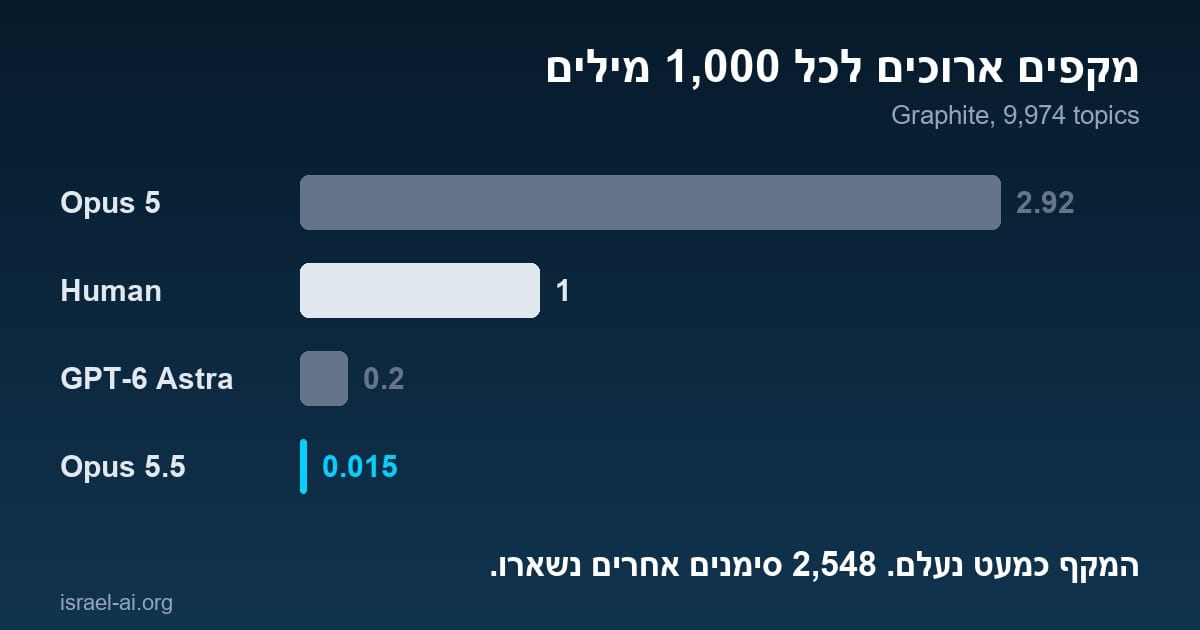
במשך שנתיים המקף הארוך היה "טביעת האצבע" המפורסמת ביותר של טקסט שנכתב ב-AI. מחקר חדש של חברת Graphite, שפורסם ב-1 באוקטובר 2026, מראה שהסימן הזה כמעט נעלם: Claude Opus 5.5 משתמש ב-0.015 מקפים ארוכים לכל אלף מילים, לעומת 2.92 בגרסה הקודמת, Opus 5. ירידה של 99%.
אבל הכותרת האמיתית של המחקר היא אחרת. החוקרים מצאו ב-Opus 5.5 עוד 2,548 "סימנים מסגירים": מילים, ביטויים ותבניות שהמודל משתמש בהם לפחות פי שניים יותר מכותבים אנושיים. זה רק 4% פחות מאשר ב-Opus 5. במילים אחרות, ה-AI הפסיק להשתמש במקף, אבל לא הפסיק להישמע כמו AI.
איך נעשה המחקר
Graphite, חברת שיווק תוכן, השוותה 9,974 נושאים זהים שנכתבו על ידי עשרה מודלים: ארבע גרסאות של Claude, ארבע של GPT ו-Gemini 3.1 Pro. כבסיס להשוואה שימשו כתבות שבני אדם כתבו על אותם נושאים, כולן מלפני ChatGPT, כדי לוודא שאין בהן השפעה של AI. "סימן מסגיר" הוגדר כמילה, צירוף או תבנית שמופיעים במודל לפחות פי שניים מאשר אצל בני אדם, אחרי נרמול לאורך הטקסט.
זה המשך של מחקר רחב יותר של Graphite מספטמבר, שמצא כמעט 13,000 סימנים כאלה בתשעה מודלים, ו-65% מהם ייחודיים למשפחת מודלים אחת. כלומר, כל חברה מייצרת "מבטא" משלה.
המקף הארוך: מסימן היכר לכמעט אפס
| מקור הטקסט | מקפים ארוכים לכל 1,000 מילים |
|---|
| Claude Opus 5 | 2.92 |
| כותבים אנושיים (לפני ChatGPT) | כ-1.0 |
| GPT-6 Astra | כ-0.2 |
| Claude Opus 5.5 | 0.015 |
הנתון המעניין: גם Opus 5.5 וגם Astra של OpenAI משתמשים היום במקף ארוך הרבה פחות מבני אדם. מי שעדיין מחפש מקפים כדי לזהות AI יגיע למסקנה הפוכה: דווקא הכותב האנושי ייראה חשוד.
אלה הביטויים שעדיין מסגירים את Claude
הטבלה מציגה את הסימנים הבולטים ש-Graphite מצאה ב-Opus 5.5, ופי כמה הם נפוצים יותר מאשר בכתיבה אנושית. הסימנים באנגלית, אבל כמו שאפרט בהמשך, לרובם יש מקבילה ברורה בעברית.
| סוג הסימן | ביטוי | פי כמה מבני אדם |
|---|
| הדגשת חשיבות | this matters | 116 |
| why _ matters | 92 |
| just as important | 13 |
| ניגוד מלאכותי | is more than a _ it | 98 |
| rather than simply | 32 |
| not only about | 13 |
| מעברים | looking ahead the | 40 |
| adds another layer | 27 |
| what comes next | 24 |
| שמות תואר מעריכים | dependable | 23 |
| steady | 11 |
| thoughtful | 9 |
יש גם סימנים חדשים. בהשוואה ל-Opus 5, הגרסה החדשה הרבה יותר "עוזרת": הביטוי "is especially helpful" נפוץ בה פי 12, ו-"can help you" פי 8. מנגד, היא ויתרה על ההתלהבות של קודמתה. "is genuinely" נפוץ ב-Opus 5 פי 26 יותר מאשר ב-Opus 5.5. הסימנים לא נעלמים. הם פשוט מתחלפים.
Claude מתקרב לכתיבה אנושית, GPT מתרחק
מעבר לספירת ביטויים, Graphite מדדה כמה התפלגות המילים של כל מודל רחוקה מזו של בני אדם (מדד Jensen-Shannon, נמוך יותר פירושו קרוב יותר), וכמה הכתיבה "מליצית" בסולם של 0 עד 100.
| מודל | מרחק מהתפלגות מילים אנושית | ציון "כתיבה מליצית" |
|---|
| Claude Opus 5 | 0.064 | 16.75 |
| Claude Opus 5.5 | 0.052 (שיפור של 19%) | 10.57 (ירידה של 37%) |
| GPT-5.6 Sol | 0.101 | לא דווח |
| GPT-6 Astra | 0.109 (התרחקות של 8%) | כ-8.3 |
| כותבים אנושיים | בסיס | 6.65 |
התמונה מורכבת. ב-Astra הכתיבה פחות מליצית, אבל אוצר המילים שלו רחוק יותר מזה של בני אדם, ו-79% מהפער מול Opus 5.5 נובע ממילות תוכן: שמות עצם, פעלים ותארים. Astra גם נוטה להסתייג הרבה יותר. הצירוף "does not establish" נפוץ אצלו פי 275 מאשר ב-Opus 5.5. Claude, לעומתו, אוהב סופרלטיבים: "the most popular" מופיע אצלו פי 45 יותר מאשר ב-Astra.
ועוד נתון ששווה לשים לב אליו: קצב השיפור מאט. מ-Opus 4 ל-Opus 5 מספר הסימנים ירד ב-18%. מ-Opus 5 ל-Opus 5.5, רק ב-4%. בראיון ל-VentureBeat אמר מנכ"ל Graphite, איתן סמית', שכל מודל פשוט "שונה", ושזה הפתיע אותם.
אז איך מזהים טקסט שנכתב ב-AI בעברית?
המחקר עוסק באנגלית, אבל אני עורך טקסטים בעברית כל יום, והתבניות חוזרות כמעט אחד לאחד. זו הרשימה שאני עובד איתה:
- הכרזה על חשיבות במקום להראות אותה. "וזה בדיוק העניין", "כאן נכנסת השאלה החשובה", "חשוב לציין ש". המקבילה של "this matters".
- ניגוד שלא היה צריך. "זה לא רק כלי, זו דרך חשיבה", "לא מדובר בטרנד, אלא במהפכה". כשכל פסקה בנויה על "לא X אלא Y", מישהו לא כתב אותה.
- מעברים מוכנים מראש. "במבט קדימה", "וזה מוסיף רובד נוסף", "אז מה הלאה?". הם מחברים פסקאות בלי להוסיף מידע.
- שמות תואר שמעריכים במקום לתאר. "פתרון אמין ומשמעותי", "גישה מעמיקה ומדויקת". אם אפשר למחוק את התואר בלי לאבד מידע, כנראה שהוא שם בשביל הצליל.
- פתיחות וסגירות גנריות. "בעולם המשתנה במהירות", "לסיכום, ניתן לומר כי". כותב אנושי פותח בעובדה ומסיים כשנגמר לו מה להגיד.
- שלישיות. "יעיל, מהיר וחסכוני". בני אדם כותבים לפעמים שניים, לפעמים ארבעה.
- אין שום דבר שרק הכותב יכול לדעת. אין שם של לקוח, מספר מתוך פגישה, טעות שקרתה. זה הסימן החזק מכולם, ושום עדכון מודל לא ייעלם אותו.
המדריך של עורכי ויקיפדיה לזיהוי כתיבת AI, שפורסם לציבור ב-2025, מתאר תבניות דומות מאוד: הגזמה בחשיבות של כל נושא, טון שיווקי, מעברים שחוזרים על עצמם ושלישיות. אבל הוא גם מזהיר שאף אחד מהסימנים האלה לא מוכיח לבד שטקסט נכתב ב-AI. המודלים למדו מכתיבה אנושית, וגם בני אדם כותבים "חשוב לציין".
ולמה לא פשוט להריץ את הטקסט בתוכנת זיהוי?
כי הן לא אמינות מספיק כדי לקבל עליהן החלטות על אנשים. OpenAI עצמה השיקה בינואר 2023 כלי לזיהוי טקסט AI וסגרה אותו ביולי 2023 בגלל "שיעור דיוק נמוך". הכלי היה לא אמין בטקסטים קצרים וסימן לפעמים טקסט אנושי כאילו נכתב במכונה. המחקר של Graphite מסביר למה זה קשה: הסימנים משתנים בכל גרסה, ושונים בין חברה לחברה. גלאי שלמד לזהות את Opus 5 לא בהכרח יזהה את Opus 5.5.
מה זה אומר לארגון שלכם
אני שומע את השאלה "איך נדע אם העובדים כתבו את זה ב-AI?" כמעט בכל סדנה. לדעתי זו השאלה הלא נכונה.
- לעובדים: הבעיה היא לא שהשתמשתם ב-AI. הבעיה היא כשרואים את זה. לפני ששולחים מייל, מסמך או פוסט שנכתבו בעזרת AI, תעברו על שבעת הסימנים שלמעלה ותמחקו כל משפט שלא אומר כלום. ותוסיפו לפחות דבר אחד שרק אתם יודעים.
- למנהלים: אל תנסו לצוד טקסטים של AI. תגדירו סטנדרט איכות: טקסט צריך להיות מדויק, ספציפי ובאחריות של מי שחתום עליו, לא משנה איך נכתב. כתבתי על המחיר של הגישה ההפוכה בכתבה על מדידת עובדים בעידן ה-AI.
- למי שכותב תוכן שיווקי: גוגל הבהירה כבר ב-2023 שהיא בודקת את איכות התוכן ולא את הדרך שבה הוא נוצר. אבל לקוחות כן שמים לב לטקסט שנשמע גנרי. וטקסט כזה פוגע באמון גם כשהמידע בו נכון.
יש גם צד שני: כשה-AI כותב לעובדים, ועובדים אחרים מסכמים את זה שוב ב-AI, אף אחד כבר לא באמת קורא. הרחבתי על זה בכתבה על מסמכים שה-AI כותב ל-AI.
מה אני הייתי עושה עכשיו
הייתי מוסיף לכל הנחיה קבועה שהצוות שלי נותן ל-AI שלוש שורות: בלי ביטויים שמכריזים על חשיבות, בלי "לא X אלא Y", ובלי שמות תואר שלא מוסיפים מידע. זה לא יעלים את כל 2,548 הסימנים, אבל זה יוריד את הבולטים שבהם. גם ב-Graphite אומרים שזה עובד: מנהל ה-AI שלהם, גרגורי דרוק, סיפר שהוא מבקש מהמודל במפורש לא לכתוב בסגנון מליצי. ואם אתם עובדים עם הגרסה החדשה, במדריך ל-Opus 5.5 ו-Sonnet 5.5 יש את כל השאר.