המרדף אחר אבטחת מידע בעידן הבינה המלאכותית
השילוב של כלי בינה מלאכותית יוצרת (GenAI) בארגונים הוא כבר עובדה מוגמרת. עובדים מזינים מדי יום נתונים, קוד, מסמכים ומידע רגיש לתוך פרומפטים כדי לייעל את עבודתם. המציאות הזו מדירה שינה מעיניהם של מנהלי אבטחת מידע (CISO), שמחפשים בנרות פתרונות למניעת דלף מידע (DLP - Data Loss Prevention) שיוכלו לפקח, להתריע ולחסום העברת נתונים רגישים למודלים ציבוריים. התוצאה היא פריחה של עשרות פתרונות אבטחה המציעים לשבת כ"שכבת מגן" בין הארגון לבין ה-AI.
המודלים הגדולים כבר מאובטחים ותקניים
לפני שממהרים לרכוש שכבות הגנה חיצוניות, חשוב להכיר בעובדה משמעותית: סביבות ה-AI הארגוניות המובילות כיום (כגון הגרסאות הארגוניות של Microsoft Copilot, OpenAI, ו-Anthropic) תוכננו מראש כדי לעמוד בדרישות האבטחה המחמירות ביותר. הן עומדות בתקנים גלובליים (כמו SOC2 ו-GDPR), מצפינות את המידע, וחשוב מכל – מתחייבות משפטית שלא להשתמש במידע הארגוני שלכם לאימון המודלים שלהן. כאשר עובדים בסביבה ארגונית מוסדרת, המידע נשאר מוגן בתוך גבולות הגזרה של הארגון.
פרדוקס המתווך: כששכבת ההגנה הופכת לנקודת תורפה
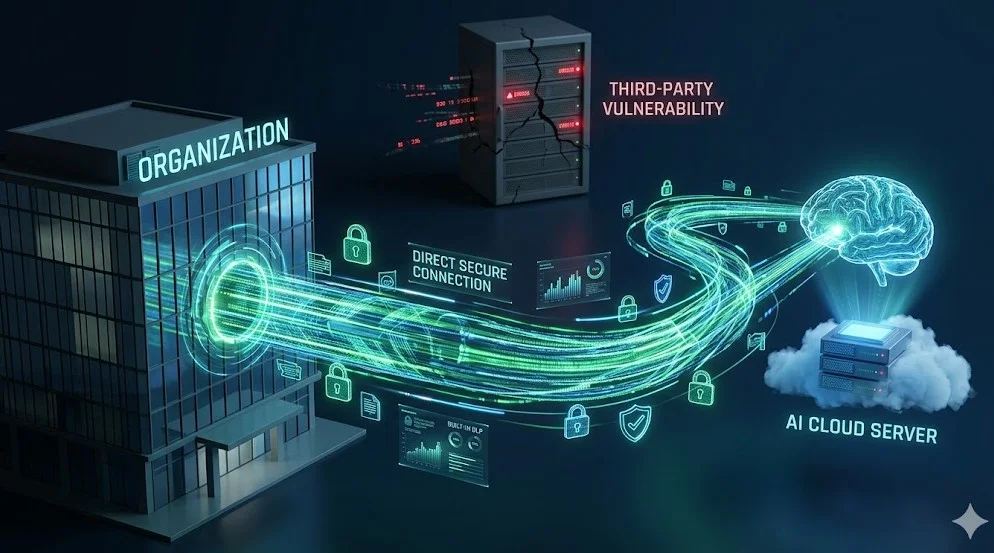
כאן טמונה הבעיה האמיתית עם פתרונות ה-DLP החיצוניים ל-AI: ברגע שארגון מחליט להעביר את כל תעבורת הפרומפטים שלו דרך שרת או שירות של ספק צד-שלישי (Proxy / Gateway) כדי שיסרוק את המידע לפני שהוא מגיע למודל, הוא למעשה יוצר נקודת כשל בודדת (Single Point of Failure). אותו ספק אבטחה מחזיק כעת בגישה ישירה לכל המידע העסקי הרגיש ביותר שעובר בארגון. אם הספק הזה, שאינו ענקית טכנולוגיה, יחווה פריצת אבטחה – כל המידע של הארגון שלכם יעמוד בסכנה. במקום להגן על המידע, הארגון רק הוסיף חוליה חלשה בשרשרת.
הכל מתחיל ונגמר במדיניות ברורה
מלבד הפתרונות של ענקיות הטכנולוגיה שעומדים בתקינה מובנית, אין כיום פתרונות "קסם" גורפים שמתאימים לכל ארגון. הטמעה של כלי הגנה ללא תשתית ניהולית תידון לכישלון. לכן, לפני שרוכשים תוכנה, נדרשת מדיניות ארגונית ברורה: אילו כלי AI מותרים לשימוש? מהן דרישות הרגולציה והתקינה החלות על החברה? איזה מידע אסור בשום אופן להעלות לענן? וכיצד ניתן למנף כלי אבטחה שכבר קיימים בארגון (כמו פתרונות ה-DLP המובנים של מיקרוסופט)? רק לאחר גיבוש תפיסת ההפעלה, ניתן לבחון פתרונות טכנולוגיים משלימים.
מי הן השחקניות המובילות בשוק ומה הן מציעות?
בשוק פתרונות ה-DLP המותאמים לבינה מלאכותית פועלות כיום מספר שחקניות מרכזיות, שכל אחת מהן מציעה זווית התמודדות מעט שונה לאתגר. עבור ארגונים השקועים עמוק בסביבת העבודה של מיקרוסופט, הפתרון הטבעי והמוביל הוא Microsoft Purview, שמציע אינטגרציה חלקה עם סביבת ה-Copilot ויכולות ניהול מדיניות ישירות על תחנות הקצה. לצידו, בולטות חברות כמו Nightfall AI ו-Concentric AI, המתמחות בניתוח סמנטי עמוק בזמן אמת של הפרומפטים כדי לזהות מידע רגיש (PII) לפני שהוא נשלח למודל חיצוני.
גישה נוספת מגיעה מכיוון חברות כמו LayerX, המציעות אבטחה ברמת הדפדפן (Browser Extension) שמאפשרת לארגון לשלוט באופן נקודתי בפעולות כמו "העתק-הדבק" אל תוך ChatGPT ללא התקנת סוכנים כבדים על המחשבים. בנוסף, כלים הדוגלים בגישת "היסטוריית המידע" (Data Lineage), כמו Cyberhaven, צוברים תאוצה משום שהם יודעים לעקוב מאיזה קובץ או מסד נתונים הגיע המידע המועתק, ולחסום את הפעולה על בסיס רגישות המקור ולא רק לפי זיהוי מילות מפתח. המגוון הזה מדגיש שוב מדוע בחירת הכלי חייבת להיגזר מצרכי הארגון ותשתיותיו הקיימות.
מה חושבים המומחים בשטח? תובנות מ-Reddit
בדיון מקצועי ומרתק שעלה לאחרונה בקהילת אבטחת המידע r/AskNetsec ב-Reddit, מנהלי אבטחה שיתפו מניסיונם באתגרי ה-DLP מול מערכות AI. המסקנות המרכזיות מהשטח היו חד-משמעיות:
ראשית, אין תחליף להגנה על המידע במקור. מומחים טענו שהגישה היעילה ביותר היא לסרוק ולסווג את הנתונים בסביבות האחסון הפנימיות (כמו SharePoint ו-OneDrive) ולהגביל גישה למידע רגיש (PII), כך שהוא כלל לא יהיה זמין לעובד שעלול להעתיק אותו ל-AI.
שנית, חסימה של "מילות מפתח" אינה עובדת ורק פוגעת בפרודוקטיביות. השוק עובר לפתרונות של "היסטוריית נתונים" (Data Lineage) שיודעים לזהות מאין הועתק המידע (למשל, ממערכת ה-CRM) ולא רק מה כתוב בו. בנוסף, הודגש כי תוספי דפדפן אינם מספיקים יותר, שכן עובדים רבים משתמשים באפליקציות שולחן העבודה של ה-AI שעוקפות את הדפדפן לחלוטין.
האם סביבת 365 שונה מהותית ברמת האבטחה ממודלי השפה?
התשובה הקצרה היא: לא. אם הארגון שלכם עושה שימוש בענן במיילים שלו, במערכות ה CRM או מערכות נוספות, משמע רמת האבטחה שלכם עשויה לאפשר לכם לעבוד ללא דאגה עם מודלי ה AI בענן, בהנחה שהם ברשיון Enterprise.

כשאין סיבה טובה לאבטחה - מוכרים לכם הבטחה
הבעיה מחריפה כאשר בוחנים את גל חברות ההזנק ה"צעירות" שמנסות לרכוב על ההייפ המשלב בין בינה מלאכותית לאבטחת מידע. רבות מהן משווקות הבטחות לפתרונות "קסם" הרמטיים, אך נתקלות מהר מאוד במציאות שבה אין להן יתרון טכנולוגי אמיתי או בשלות מול ענקיות הטכנולוגיה והשחקניות המבוססות. כדי להתגבר על חסם הכניסה, אותן חברות משנות אסטרטגיה ומציעות "מוצרים נלווים" שקורצים לכאבים אחרים של הארגון. הפיתוי הנפוץ ביותר הוא הצעת פלטפורמה מרוכזת לרכישת חבילות טוקנים וגישה למגוון רחב של מודלי שפה (LLMs) דרך ממשק אחד.
הצעה זו קוסמת מאוד למחלקות הרכש וה-IT, שכן היא חוסכת התנהלות בירוקרטית ומשפטית מול ספקים מרובים ומקלה על ניהול התקציב.
עם זאת, כאן בדיוק טמונה המלכודת: הכנסת ספק לארגון תחת הכובע של נוחות תפעולית מכניסה אותו בדלת האחורית אל נתיב המידע הרגיש ביותר של החברה. חשוב להבין שמדובר בסטייה מליבת העסק המוצהרת של אותן חברות – מניעת דלף מידע (DLP) – לטובת מודל עסקי של "מכירת מנויים" (Reselling) כניסיון לחדור לארגון בכל מחיר.
ארגונים שמתפתים לנוחות הרכש הזו עלולים למצוא את עצמם מפקידים את תעבורת הנתונים הקריטית שלהם בידי חברות שאין להן את החוסן, הניסיון או התשתית לספק הגנת סייבר אמיתית. התוצאה היא תחושת אבטחה מזויפת: הארגון משלם בפועל על פלטפורמת ניהול רישיונות שמתחפשת למערכת אבטחת מידע, ומייצר לעצמו את אותה נקודת תורפה של חשיפת המידע לצד שלישי שאינו הכרחי.
כך תבחנו את ספקי ה DLP עבור ה AI בארגון שלכם
כדי להבטיח שהארגון שלכם בוחר בפתרון ה-DLP הנכון ולא מכניס בטעות סיכון מיותר למערכת, יש לבחון את הספקים בקפידה. הכנו עבורכם רשימת בדיקה הכוללת 10 שאלות קריטיות שחובה לשאול כל ספק DLP לעולמות ה-AI לפני חתימה על הסכם:
יכולות זיהוי סמנטי לעומת מילות מפתח: האם המערכת מבינה הקשר ויודעת לזהות מידע רגיש באמת (PII, קוד, נתונים פיננסיים), או שהיא נשענת על חסימת מילות מפתח מיושנת שתציף את הארגון בהתראות שווא ותעצור את העבודה השוטפת?
אבטחת התעבורה ומניעת נקודת כשל: מהי רמת ההצפנה ויציבות התעבורה בין הארגון שלכם לבין הספק, ובין הספק לבין מודל ה-AI? חובה לוודא שניתוב המידע הזה לא הופך את מי שאמור להיות "שכבת ההגנה" שלכם לפרצת אבטחה ולשכבת חדירה נוחה עבור תוקפים.