ארגון ה-AI הישראליארגון ה-AI הישראלי
סוכני AI בוחנים נתונים ומבצעים פעולות בסביבה ארגונית מורכבת, על רקע דיאגרמות של מדדי ביצועים.
חדשות AI

מעבר לציון: מדדי הביצועים הקריטיים שיקבעו את הצלחת סוכני AI בארגון

ליאור אברהםליאור אברהם 4 דק׳ קריאהעודכן:

השינוי הפרדיגמטי בהערכת סוכני AI בסביבה עסקית

המעבר החד של סוכני בינה מלאכותית (AI Agents) ממעמד של הדגמות מחקריות ליישומים מבצעיים בתוך ארגונים, הציב אתגר מהותי בפני קהילת ה-AI ואנשי העסקים כאחד: כיצד מודדים באופן אמין את מידת יעילותם ואיכותם של סוכנים אלו בסביבת עבודה דינמית? מדדי ביצועים מסורתיים, כגון ציון Perplexity או מיקום בטבלת ה-MMLU (Massive Multitask Language Understanding) עבור מודלי שפה גדולים (LLMs), אינם מסוגלים לספק תובנות עמוקות לגבי יכולתו של סוכן AI לנווט באתר אינטרנט מורכב, לפתור תקלת תוכנה ב-GitHub, או לנהל זרימת עבודה מרובת שלבים בשירות לקוחות. הצורך במדדי הערכה המדמים באופן מדויק תרחישי B2B וצרכים ארגוניים הפך לקריטי, והוא למעשה המפתח להטמעה מוצלחת ורווחית של טכנולוגיות אלו.

האתגר המורכב שבהערכה אובייקטיבית: מעבר למספר בודד

הערכה אפקטיבית של סוכני AI דורשת הבנה עמוקה של מורכבות המערכת. חשוב להכיר בכך שציוני מדדי ביצועים תלויים מאוד ב'פיגומים' (scaffold) שסביב המודל: עיצוב הפרומפט, גישה לכלים חיצוניים, תקציב ניסיונות חוזרים (retry budget), סביבת ההרצה ואפילו גרסת המעריך – כל אלה יכולים לשנות מהותית את התוצאות המדווחות. משמעות הדבר היא ששום מספר בודד אינו יכול להיקרא במנותק מהקשרו. ארגונים המבקשים להטמיע סוכני AI חייבים להפנים כי הערכה אינה פעולה חד-פעמית או הסתמכות על ציון גנרי, אלא תהליך מתמשך של בדיקה, אימות וכיול המותאם לדרישות הספציפיות של המשימה והסביבה העסקית, תוך התחשבות במגוון הרחב של גורמים המשפיעים על ביצועי הסוכן.

SWE-bench: מבחן הריאליזם בהנדסת תוכנה אוטונומית

אחד ממדדי הביצועים הבולטים שמספקים איתות אמיתי ליכולות סוכניות הוא SWE-bench, המתמקד בהנדסת תוכנה בעולם האמיתי. מדד זה בוחן את יכולתם של מודלי שפה וסוכני AI לפתור בעיות אמיתיות שמקורן ב-GitHub, מתוך מאגר של אלפי בעיות מ-12 מאגרי Python פופולריים. המשימה אינה רק לתאר פתרון, אלא לייצר 'תיקון' (patch) עובד שעובר את כל בדיקות היחידה. מדד זה קריטי במיוחד לארגונים המפתחים תוכנה, שכן הוא מדגים פוטנציאל לאוטומציה של תהליכי תיקון באגים, שיפורי קוד וניהול תצורה. ההתקדמות במדד זה, מ-1.96% פתרונות ב-2023 לטווח של 80% בדגמי קצה ב-2026, מצביעה על קפיצת מדרגה משמעותית, אם כי יש לזכור שציונים גבוהים ב-SWE-bench מצביעים על חוזק במשימות תיקון תוכנה ספציפיות ואינם מעידים בהכרח על אוטונומיה כללית.

GAIA: אמת המידה ליכולות סיוע כלליות ומורכבות

מדד ה-GAIA (General AI Assistant) בוחן יכולות סיוע כלליות הדורשות שרשרת פעולות הגיונית מרובת שלבים, גלישה באינטרנט, שימוש בכלים והבנה מולטימודלית בסיסית. משימות GAIA מנוסחות בפשטות מטעה, אך דורשות רצף של פעולות לא טריוויאליות להשלמתן הנכונה – בדיוק סוג המשימות המורכבות שסוכן וירטואלי אמיתי יתמודד איתן בשטח. עבור ארגונים המחפשים סוכנים בעלי יכולות סיוע רחבות, למשל בתחומי שירות לקוחות מתקדמים, ניהול ידע ארגוני או תמיכה במשתמשים, GAIA מהווה כלי הערכה חיוני. עיצובו הייחודי מונע קיצורי דרך ומאלץ את הסוכן להפגין הבנה תפעולית עמוקה, ובכך הוא חושף נקודות תורפה בשימוש בכלים ופערי שחזור שעלולים לחמוק ממדדים צרים יותר.
WebArena: האוטונומיה הדיגיטלית בסביבות ווב ארגוניות

היכולת לנווט באופן אוטונומי בסביבות ווב ריאליסטיות היא אבן יסוד עבור סוכני AI רבים המיועדים ליישומים ארגוניים, וזה בדיוק מה שבוחן מדד ה-WebArena. מדד זה יוצר אתרים פונקציונליים בארבעה תחומים מרכזיים – מסחר אלקטרוני, פורומים חברתיים, פיתוח תוכנה שיתופי וניהול תוכן – עם פונקציונליות ונתונים המשקפים את מקביליהם בעולם האמיתי. סוכנים חייבים לפרש פקודות בשפה טבעית ברמה גבוהה ולבצע אותן במלואן באמצעות ממשק דפדפן חי. ההתקדמות ב-WebArena משמעותית, כאשר מערכות ייעודיות מדווחות על שיעורי השלמת משימות של מעל 60%. מדד זה חיוני לארגונים השואפים לאוטומציה של תהליכים עסקיים מבוססי ווב, כגון הזנת נתונים, איסוף מידע, אינטראקציה עם מערכות מורשת מבוססות דפדפן, או ניהול קמפיינים דיגיטליים, והוא בודק אוטונומיה אמיתית ולא רק אוטומציה מתוסרטת.

τ-bench: אינטראקציית סוכן-משתמש תחת אילוצים ארגוניים

מדד ה-τ-bench (Tau-bench) מתמקד באספקט קריטי נוסף להטמעת סוכני AI בארגון: אינטראקציית כלי-סוכן-משתמש תחת אילוצי מדיניות בעולם האמיתי. מדד זה מדמה סביבות דינמיות שבהן סוכנים צריכים לא רק לבצע משימות, אלא גם לציית למדיניות ארגונית, להבין מגבלות, ולהגיב לאינטראקציות אנושיות. עבור ארגונים, זהו מדד הכרחי להבטחת בטיחות, עמידה בתקנות (compliance), אתיקה ושימושיות של סוכני AI. הוא בוחן את יכולת הסוכן לפעול בגמישות ובאחריות בסביבה שבה קיימים כללי התנהגות מוגדרים, משוב משתמשים וצורך בקבלת החלטות מורכבות המשלבות היגיון, שימוש בכלים והתאמה למדיניות. יכולות אלו הן המפתח לבניית אמון בין סוכני AI למשתמשים ולמערכות הארגוניות.

החובה הארגונית: בניית אסטרטגיית הערכה הוליסטית לסוכני AI

המעבר ממעבדה לשטח מחייב את הארגונים הישראליים לאמץ גישה הוליסטית להערכת סוכני AI. במקום להסתמך על מדד בודד, חיוני לבנות סוויטת מדדי ביצועים המותאמת באופן ספציפי לצרכים העסקיים ולתרחישי השימוש המיועדים. זה כולל שילוב של מדדים כמו SWE-bench עבור משימות הנדסיות, GAIA עבור יכולות סיוע כלליות, WebArena לאוטונומיה דיגיטלית ו-τ-bench לאינטראקציה מבוקרת. על מנהלי טכנולוגיה וחדשנות בארגונים להבין כי הצלחת הטמעת סוכני AI אינה נמדדת רק בביצועים טכניים, אלא ביכולתם להשתלב באופן חלק בתהליכים קיימים, לספק ערך מוסף ברור, לציית למדיניות ארגונית ולהיות ניתנים לניהול ולניטור. בניית מסגרת הערכה קשוחה, המשלבת בדיקות פנימיות מותאמות וניטור מתמשך, היא המפתח להבטחת החזר השקעה (ROI) מיטבי, מזעור סיכונים תפעוליים ומיצוב הארגון בחזית החדשנות הטכנולוגית.

מקור הכתבה

Marktechpost
הצטרפו לקבוצת הווטסאפ שלנו לעדכונים

תגיות:

שתפו את הכתבה:

עוד כתבות שיעניינו אותך

DPO בעידן ה-AI: מה עושה ממונה הגנת הפרטיות, איפה הוא יושב בארגון וכמה הוא מרוויח
מדריכים• ליאור אברהם• 21 בנובמבר

DPO בעידן ה-AI: מה עושה ממונה הגנת הפרטיות, איפה הוא יושב בארגון וכמה הוא מרוויח

המדריך המלא לתפקיד ה-DPO: איך נולד, מה תיקון 13 וההנחיה הסופית של הרשות דורשים, למי הוא מדווח, אילו הסמכות שוות משהו, כמה מרוויחים בישראל ובעולם, ואיך ה-AI הופך אותו לאחד האנשים החשובים בארגון.

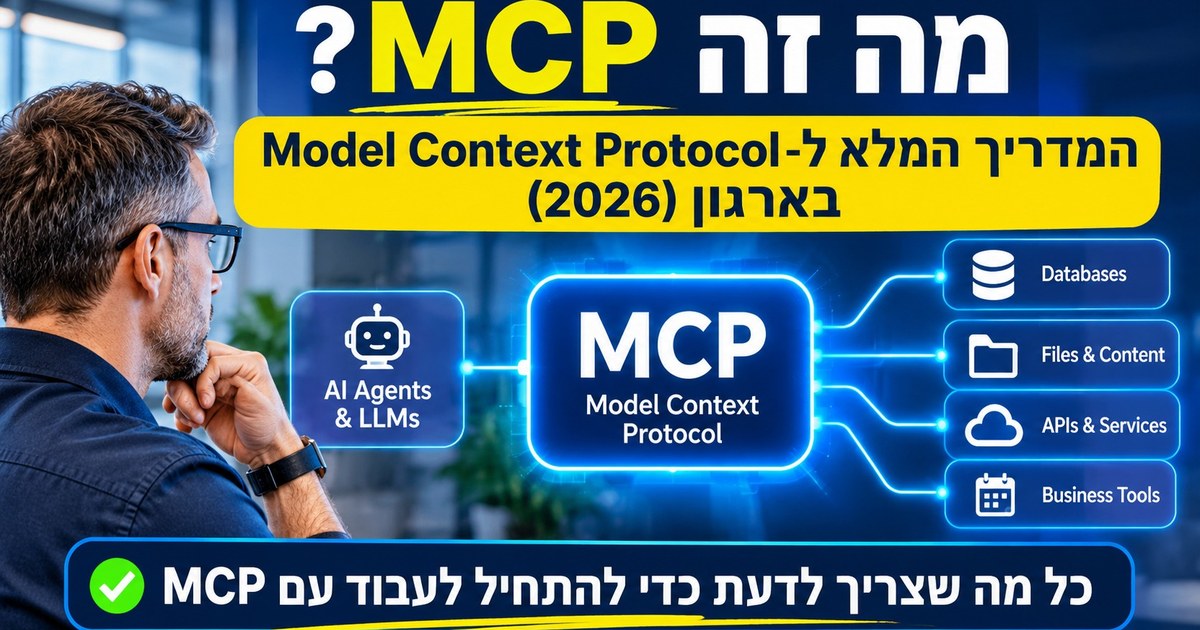
מה זה MCP? המדריך המלא ל-Model Context Protocol בארגון (2026)
מדריכים• ליאור אברהם• 15 בנובמבר

מה זה MCP? המדריך המלא ל-Model Context Protocol בארגון (2026)

MCP הוא התקן הפתוח שמחבר את Claude, ChatGPT, Gemini ו-Copilot למערכות של הארגון. מה זה בעברית פשוטה, איך זה עובד, מה ארגונים עושים עם זה בכל מחלקה, ממה להיזהר ואיך מתחילים.

מתחילים להתחשבן? מיקרוסופט שמה תקציב טוקנים לעובדים, ומה זה אומר על העובדים אצלכם
חדשות AIGeektime• ליאור אברהם• 13 בנובמבר

מתחילים להתחשבן? מיקרוסופט שמה תקציב טוקנים לעובדים, ומה זה אומר על העובדים אצלכם

מיקרוסופט הודיעה לעובדים שלה ששריפת טוקנים היא לא המטרה, הגדירה תקציב לכל חטיבה ועברה למודל זול יותר. מה קרה, למה זה קורה בכל החברות הגדולות, ואיך למדוד עובדים בעידן ה-AI בלי להפחיד אותם.

7 דרכים שבהן חברות ענק כבר משתמשות בבוט קולי, ומה הארגון שלכם יכול ללמוד מהן
מדריכים• ליאור אברהם• 13 בנובמבר

7 דרכים שבהן חברות ענק כבר משתמשות בבוט קולי, ומה הארגון שלכם יכול ללמוד מהן

בנק שעונה בטלפון 24/7, רשת נופש עם פקידת קבלה וירטואלית ובוט אחד שמדבר 35 שפות. שבעה מקרים אמיתיים של בוט קולי בארגונים גדולים, ומה ללמוד מהם לפני שמטמיעים במוקד שלכם.

שירות לקוחות עם AI ב-2027: מה עובד, מי נכשל, וכמה זה יחסוך למוקד שלכם
מדריכים• ליאור אברהם• 12 בנובמבר

שירות לקוחות עם AI ב-2027: מה עובד, מי נכשל, וכמה זה יחסוך למוקד שלכם

Klarna החליפה 700 נציגים בבוט וחזרה לגייס בני אדם. מה באמת עובד בשירות לקוחות עם AI, 5 חידושים שיגיעו ב-2027, דוגמאות מהעולם, ומחשבון שמראה אם בוט משתלם לכם.

Claude נכנס למשרד: Meetings, Sheets ו-Whiteboards הופכים אותו לכלי העבודה של הארגון
חדשות AIAnthropic• ליאור אברהם• 10 בנובמבר

Claude נכנס למשרד: Meetings, Sheets ו-Whiteboards הופכים אותו לכלי העבודה של הארגון

Anthropic השיקה גיליונות, לוחות משותפים, דשבורדים ונוכחות בפגישות, ומניית מיקרוסופט ירדה ב-3%. מה הושק, איך זה מתחבר לכל מה ש-Claude בנה השנה, ומה ארגון צריך להחליט עכשיו.

מחשבון בוט AI לשירות לקוחות
כלים• ליאור אברהם• 10 בנובמבר

מחשבון בוט AI לשירות לקוחות

כמה יחסוך בוט AI למוקד שלכם? מזינים מספר פניות, זמן טיפול ועלות נציג, ומקבלים את עלות המוקד עם בוט ובלעדיו, חיסכון חודשי, החזר השקעה ומשרות שמתפנות.

Smart Reports של Claude:  כעת המנהלים יכולים לדעת מה העובדים מפתחים  ב - AI
חדשות AIAnthropic• ליאור אברהם• 8 בנובמבר

Smart Reports של Claude: כעת המנהלים יכולים לדעת מה העובדים מפתחים ב - AI

Anthropic השיקה דוחות חכמים ל-Claude Enterprise שמנתחים את העבודה של כל צוות: מה נעשה, כמה זה עלה ואיפה העבודה נתקעת. למי זה שימושי, מה בדיוק יש בדוח, ומה צריך לסדר לפני שמפעילים.

למה הארגון שלכם חייב לגלות שהוא משתמש ב-AI, ומה יקרה אם לא
מדריכים• ליאור אברהם• 5 בנובמבר

למה הארגון שלכם חייב לגלות שהוא משתמש ב-AI, ומה יקרה אם לא

בוט תמיכה שהמציא מדיניות, קול AI שהוביל לקנס של 6 מיליון דולר, וציון אלגוריתמי שהסתיים בהסדר של 2.3 מיליון. בכל המקרים הלקוח לא ידע שמולו AI. מה החוק כבר דורש, ולמה כדאי להצטרף לתו AI אחראי עכשיו.

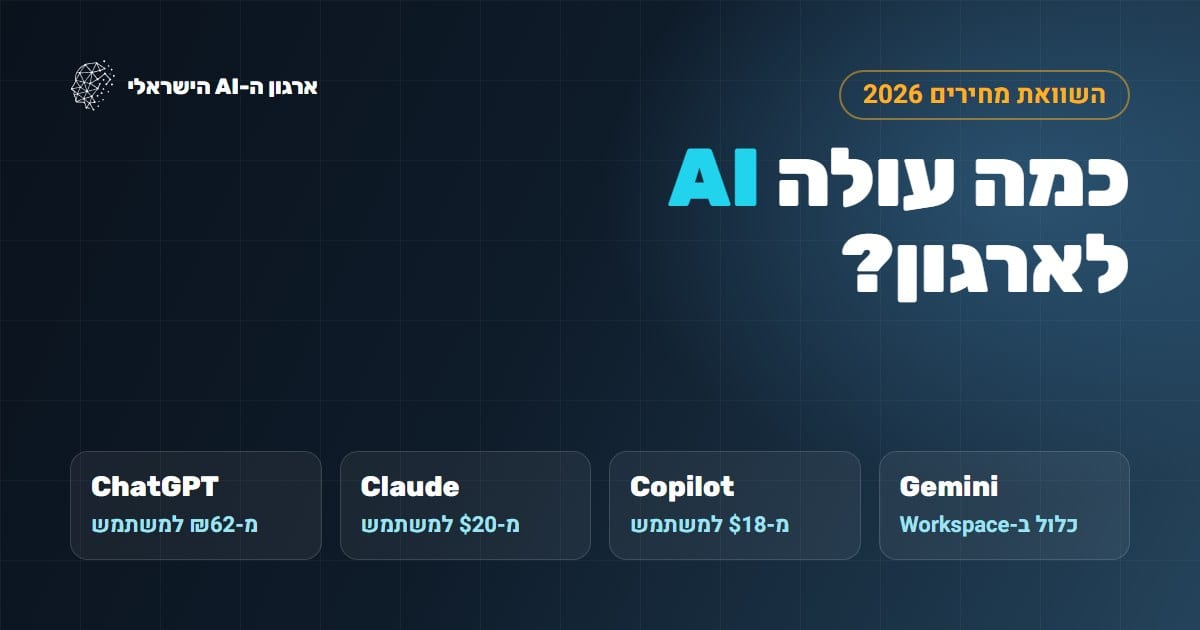
כמה עולה AI לארגון? מחירי ChatGPT, Claude, Copilot ו-Gemini לעסקים בהשוואה (2026)
מדריכים• ליאור אברהם• 1 בנובמבר

כמה עולה AI לארגון? מחירי ChatGPT, Claude, Copilot ו-Gemini לעסקים בהשוואה (2026)

מחירי כל מסלולי העסקים של ChatGPT, Claude, Microsoft 365 Copilot ו-Gemini, ישירות מעמודי התמחור הרשמיים: מחיר למשתמש, מה כלול, מנוי מול API, דוגמת חישוב לארגון של 50 עובדים והעלויות שלא מופיעות בעמוד התמחור.

הצטרפו אלינו